Quería charlar con Qwen en local y usarlo como mi director de arte y de cine.
No quería limitarme a pedirle un prompt y copiarlo en otro sitio. Quería hablar de un plano, dejar que Qwen llamase a ComfyUI, que revisase la imagen o el vídeo, comentar qué había funcionado y generar la siguiente versión. Un pequeño bucle creativo, entero en mi máquina.
En vez de eso, me quedaba sin VRAM.
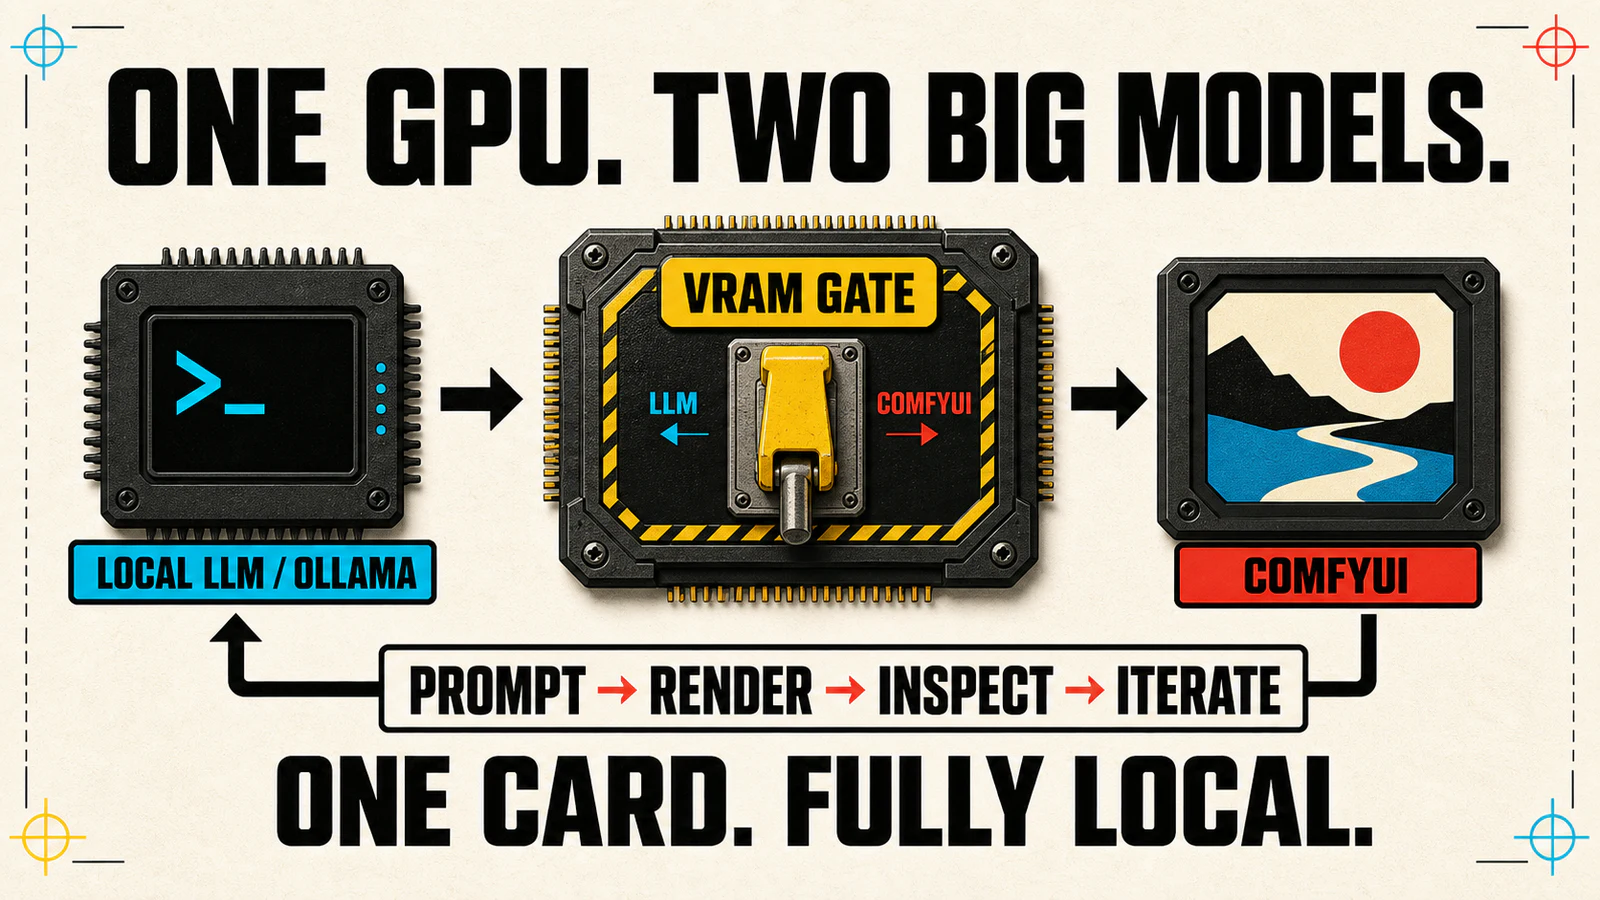
Qwen iba perfectamente en la 5090. Mis workflows de ComfyUI, también. El problema llegaba cuando empezaba el render con Qwen todavía cargado en Ollama. Así que descargaba Qwen a mano, lanzaba el workflow, descargaba los modelos de ComfyUI y volvía a cargar Qwen para la siguiente respuesta.
Se suponía que estaba hablando de iluminación y de movimientos de cámara. En realidad estaba haciendo limpieza de VRAM a mano entre mensaje y mensaje.
Si alguna vez has tenido Ollama y ComfyUI en la misma tarjeta, ya conoces el baile. Después de unos cuantos OOM, dejé de verlo como una molestia de configuración y metí el relevo dentro de OpenCode.
01 / Por qué se quedaba sin VRAM
Ollama y ComfyUI mantienen sus modelos cargados a propósito
Ninguna de las dos aplicaciones hacía nada mal. Ollama utiliza keep_alive porque descargar un modelo después de cada respuesta sería dolorosamente lento. ComfyUI también mantiene los modelos cargados porque volver a leer varios gigabytes de pesos para cada render suele ser una idea terrible.
Desde el punto de vista de OpenCode, mi workflow era secuencial:
Qwen → prompt → ComfyUI → recurso → Qwen → revisiónPero las aplicaciones no sabían nada de esa secuencia. Que Ollama devolviese una respuesta no significaba que Qwen hubiese soltado la GPU, y que terminase una tool call de ComfyUI tampoco garantizaba que sus modelos se hubiesen ido.
Había una segunda trampa. Una herramienta MCP puede responder antes de que ComfyUI haya vaciado de verdad su cola. Si liberaba la GPU en el hook after normal de OpenCode, podía devolvérsela a Ollama mientras el render todavía estaba en marcha.
Entonces, ¿qué significa «terminado» aquí?
Para Ollama significa que el modelo ha desaparecido de /api/ps, no que una petición de descarga haya respondido con un 200. Para ComfyUI significa que /queue no tiene trabajo en ejecución ni pendiente y que /system_stats muestra suficiente memoria libre. Las APIs ya contaban la verdad; yo tenía que dejar de tratar una respuesta educada como si fuese una prueba.
Por eso el plugin espera a observar esos estados. No entrega la tarjeta hasta que el modelo anterior ha desaparecido de verdad y la memoria está disponible.
02 / Lo que construí
El plugin entrega la GPU en dos fases
Escribí opencode-comfy-vram-gate, un pequeño plugin de OpenCode sin dependencias de runtime. Envuelve las llamadas MCP pesadas a ComfyUI y le da a cada una un lease exclusivo de la GPU.
Al entrar en un render, el plugin crea un lock de directorio atómico con heartbeat. Primero comprueba la cola de ComfyUI; si alguien ya está generando, se detiene ahí sin tocar Ollama. Si no, envía keep_alive: 0 para los modelos cargados en Ollama, consulta /api/ps hasta que desaparecen, llama al endpoint /free de ComfyUI y espera a que esté disponible la cantidad de VRAM configurada.
Solo entonces deja pasar la llamada MCP. El plugin fuerza wait: true y aumenta el timeout para que un render de vídeo largo no se haga pasar por una tarea rápida en segundo plano.
Al volver, espera hasta que /queue queda realmente vacía, llama otra vez a /free, comprueba la memoria y libera el lease. Ollama no se reinicia a mano; Qwen vuelve a cargarse de forma normal cuando OpenCode pide la siguiente respuesta.
La VRAM nunca se comparte en paralelo. Piensa en una sola silla: Qwen se sienta y se levanta, ComfyUI se sienta y se levanta, y vuelve Qwen.
Hay un coste, claro: cargar los pesos de un modelo lleva tiempo. Si ambos modelos caben a la vez, este plugin te ofrece una forma bastante elaborada de hacerlos más lentos. En mi máquina no cabían, así que ir más lento era una mejora considerable frente a que todo reventase.
03 / Recuperación
La primera versión podía bloquearse después de un render fallido
La primera versión ya sabía entregar la GPU y recuperarla. Hasta que falló una herramienta de ComfyUI y OpenCode nunca llamó al hook after.
El plugin tenía ahora dos malas opciones. Si borraba el lease inmediatamente, Ollama podía volver a cargarse mientras ComfyUI aún generaba. Si lo conservaba para siempre, el siguiente render de la misma sesión quedaba bloqueado contra su propio lock abandonado. Y había una condición de carrera más entretenida: Qwen podía regresar antes de que el evento de error llegase al plugin y ocupar otra vez la VRAM justo cuando empezaba la recuperación.
La versión 0.1.1 salió de perseguir esos fallos en vez de fingir que el ciclo de vida era más limpio. Los errores terminales de una herramienta ahora activan la recuperación inmediatamente. Si el hook no llega, lo cubren los eventos de sesión: inactiva, con error o eliminada. Antes de otra llamada pesada, el plugin comprueba si esa sesión dejó un huérfano. La recuperación también descarga Ollama por segunda vez si el modelo consiguió colarse de nuevo.
El lease es un directorio atómico con información del propietario y un heartbeat. Otro proceso puede reclamarlo si el PID del propietario ha muerto en la misma máquina o si el heartbeat se ha quedado viejo. Suena exagerado hasta que dos sesiones de OpenCode deciden a la vez que la GPU está libre.
El repositorio tiene 17 tests para estos casos con servidores simulados de Ollama y ComfyUI. Uno hace que la herramienta responda antes de terminar el render. Otro recarga Ollama durante la recuperación. Otro intenta robar el lease desde una segunda llamada. Con npm test recorres los caminos feos sin echar al Qwen de verdad de tu máquina, que me parece la cortesía mínima que se le puede pedir a un plugin de VRAM.
04 / Alcance
Gestiona VRAM, no el proceso creativo
No elige Krea, LTX, MiniMax ni ningún otro modelo de ComfyUI. No selecciona el workflow, escribe el prompt, escoge una LoRA, revisa el resultado ni decide si vale la pena iterar. Las instrucciones, skills y herramientas MCP de OpenCode ya tienen opiniones suficientes sobre todo eso.
El gate solo se hace una pregunta, bastante aburrida: ¿a quién le toca?
La versión 0.1 tiene un alcance estrecho a propósito: Linux, OpenCode 1.x, Ollama, una tarjeta NVIDIA y un servidor ComfyUI local. No he validado Windows nativo y la memoria unificada de un Mac es otro problema. Prefiero escribir esa frase antes que poner «cross-platform» en el README y que la sorpresa se la lleve quien lo instale.
Tampoco utilizaría unloadPolicy: all en un servidor Ollama compartido, salvo que hacer desaparecer los modelos de todo el mundo forme parte del plan. El plugin permite definir una lista explícita. Ni Ollama ni ComfyUI ganan autenticación gracias a este código, así que los dos endpoints tienen que seguir en una red de confianza.
Y no, 17 tests contra servicios simulados no convierten esto en un laboratorio de compatibilidad de hardware. Me dan confianza en la máquina de estados y en los fallos que ya conozco. Más tarjetas, drivers e implementaciones MCP encontrarán otros nuevos. Para eso están los números de versión.
Volver al experimento
Ahora puedo continuar la conversación después del render
El plugin nunca fue el experimento que quería hacer. Quería sentarme con Qwen, hablar de una imagen o una escena, dejar que generase algo y continuar la conversación a partir del resultado.
Antes del gate, cada llamada a ComfyUI podía acabar con esa conversación por un OOM o por una ronda de descargas manuales. Ahora cada render es un turno: Qwen escribe el prompt y se aparta, ComfyUI genera, y Qwen vuelve para mirar lo que ha salido.
Generar la primera imagen siempre fue la demo fácil. Lo que yo quería era un director que siguiera ahí para hablar de la siguiente, sin tener que abrir nvidia-smi entre mensaje y mensaje.
Ver el trabajo