Empecé comparando un modelo local con varios modelos frontier y acabé con una pregunta bastante más útil entre manos: ¿cuánta de la inteligencia que le atribuimos a un agente es en realidad planificación, diseño del harness y saber cuándo dejar de programar para ponerse a comprobar el producto?
La idea original era sencilla: darles a varios agentes de programación un encargo serio, en un único intento y sin rescate humano, y comparar lo que entregaban de verdad. Aplicaciones completas, que tenían que compilar, arrancar, aguantar las comprobaciones en el navegador y parecer productos.
Probamos un juego al estilo FarmVille, una web para un restaurante, un editor de píxeles y, por último, una herramienta CAD para planos de interiores. Las primeras rondas sirvieron, pero me pusieron delante un problema que ya no podía ignorar: estaba comparando modelos metidos en harnesses muy distintos. Claude y Codex llegan con años de trabajo de producto alrededor del modelo. Mi Qwen local, no.
Y esto es importante. Cuando un modelo local pierde, ¿qué es exactamente lo que pierde? Un modelo potente dentro de un bucle flojo puede pasarse una hora releyendo archivos, olvidar la tarea después de una llamada a una herramienta o terminar con medio producto precioso. Llamar a todo eso «calidad del modelo» es cómodo, pero no es exacto.
01 / La prueba
Seis agentes y un encargo deliberadamente incómodo
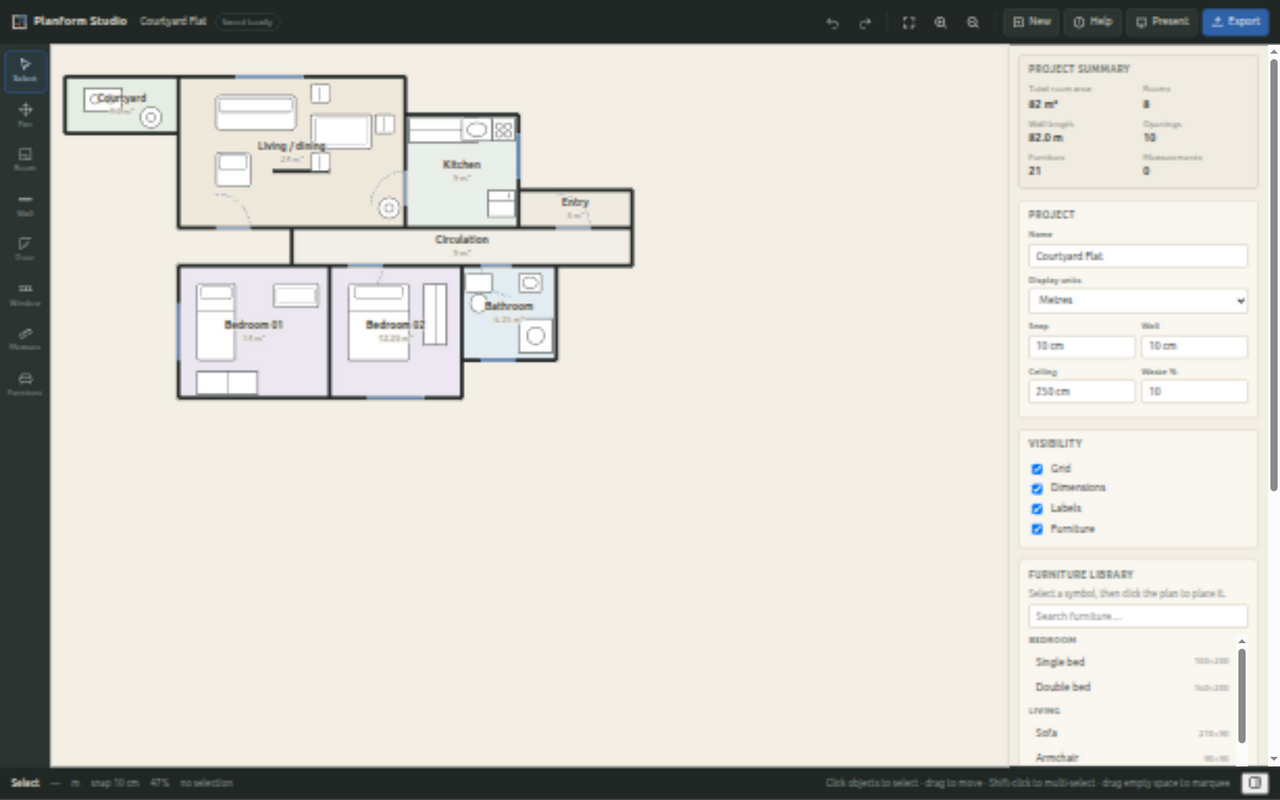
La última tarea fue una aplicación CAD de interiores llamada Planform Studio. Tenía que incluir habitaciones, paredes, puertas, ventanas, muebles, medidas, deshacer y rehacer, persistencia, exportaciones, controles de teclado, layouts adaptables, accesibilidad y un proyecto inicial que permitiera entender el editor nada más abrirlo.
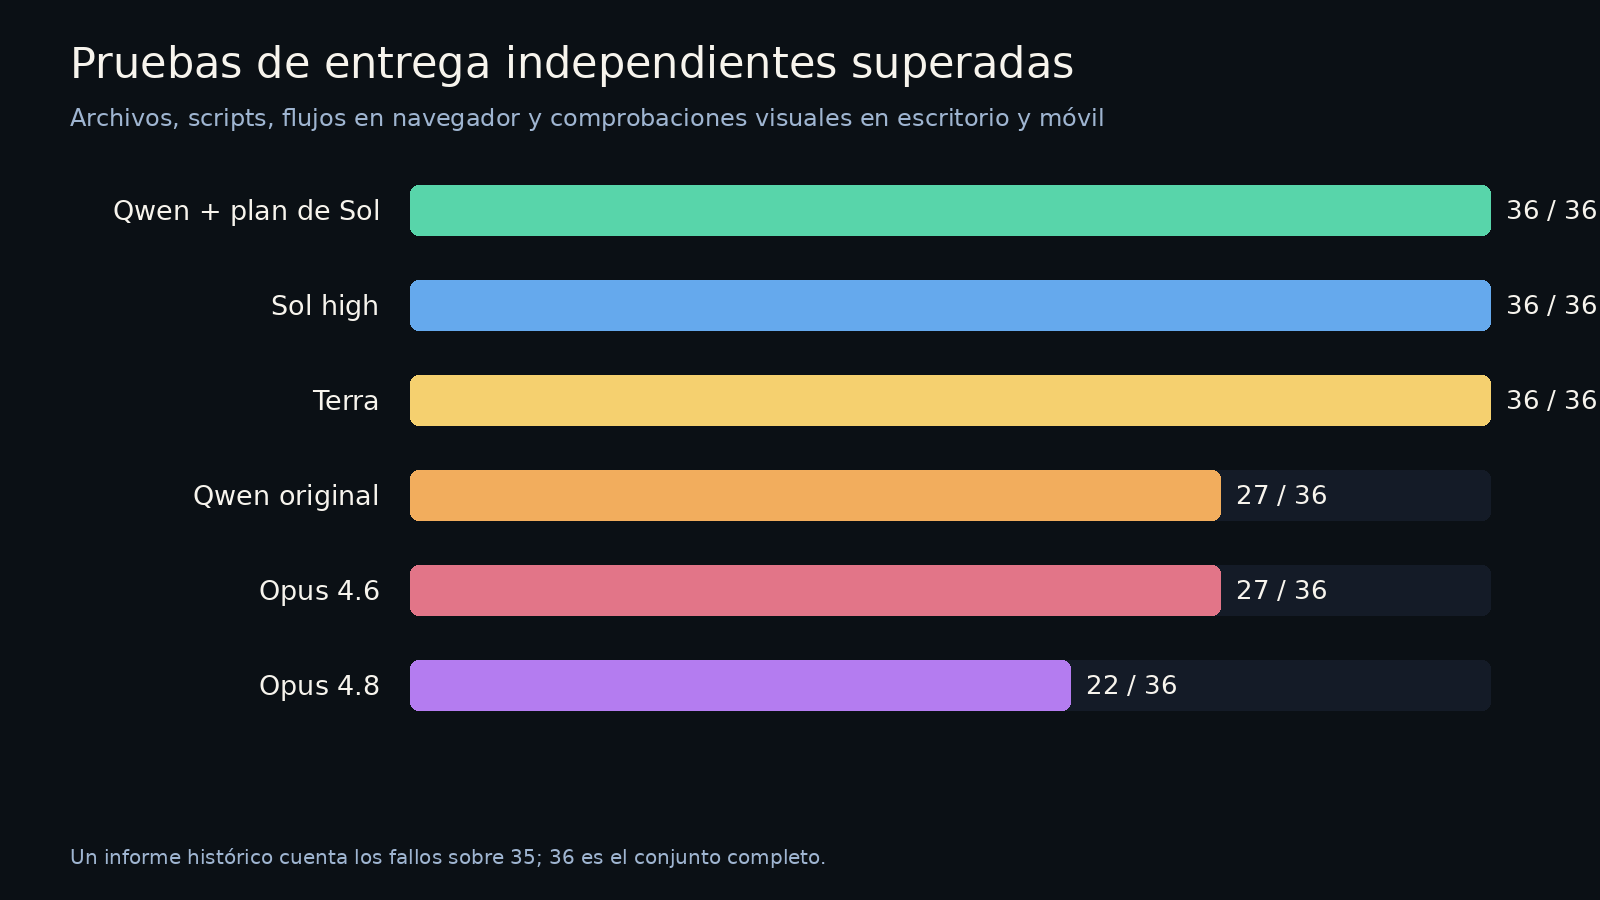
Todas las ejecuciones empezaron con el mismo prompt. Cuando un agente paró, su espacio de trabajo quedó congelado. No arreglé funciones rotas antes de la revisión. En el repositorio siguen las cuatro trayectorias incompletas, porque esconder los fallos habría hecho el experimento bastante menos útil.
| Participante | Entrada | Harness | Tiempo | Puntuación |
|---|---|---|---|---|
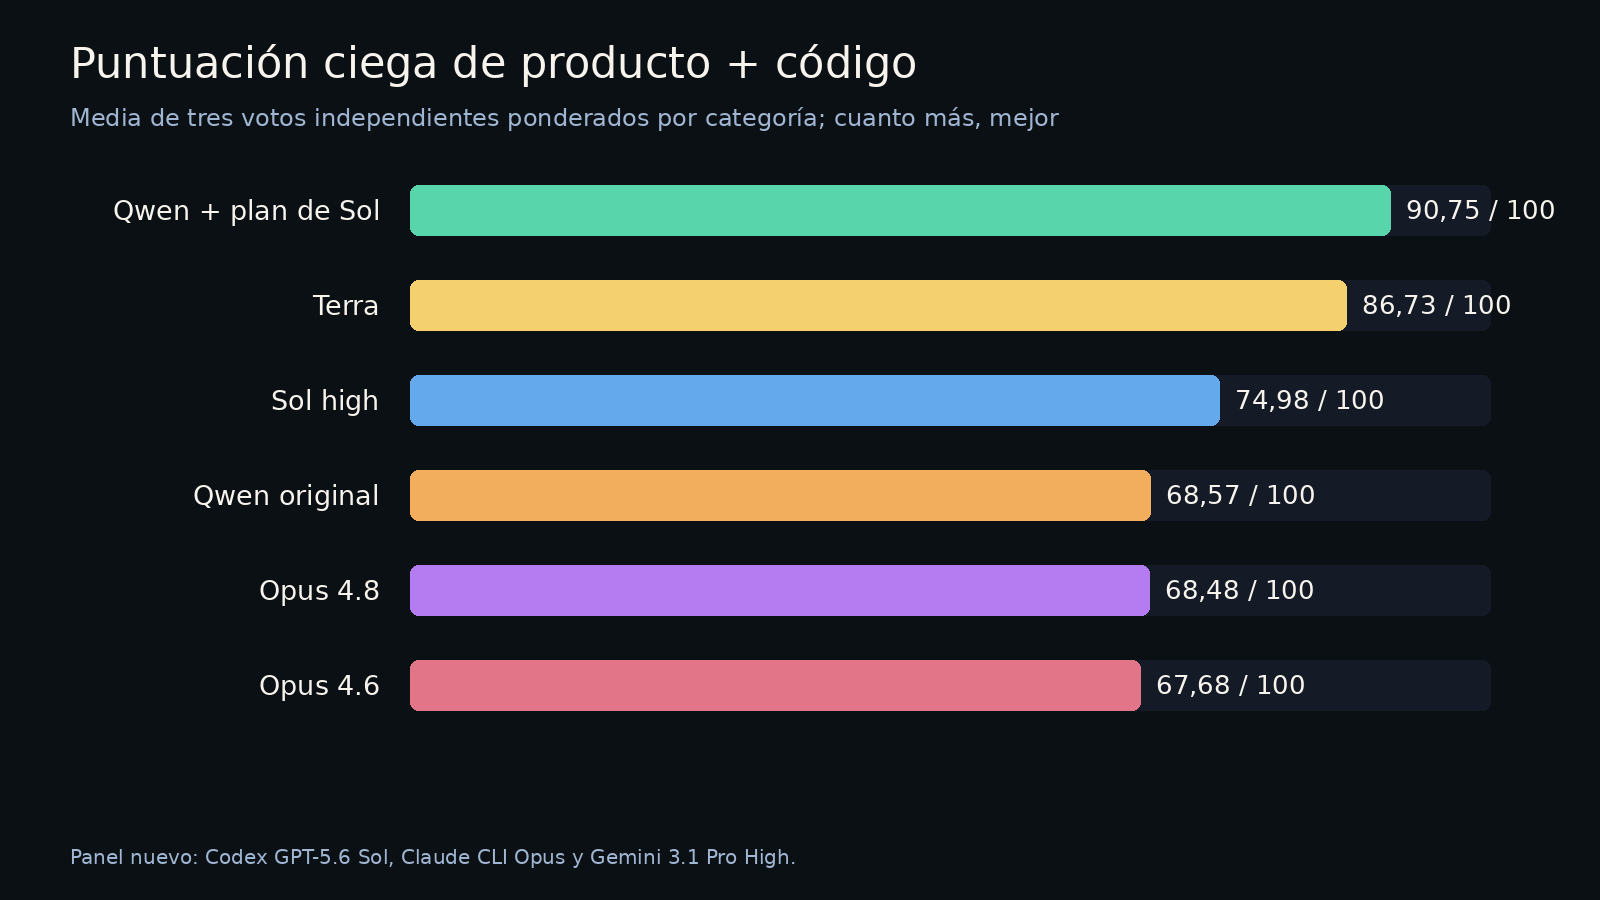
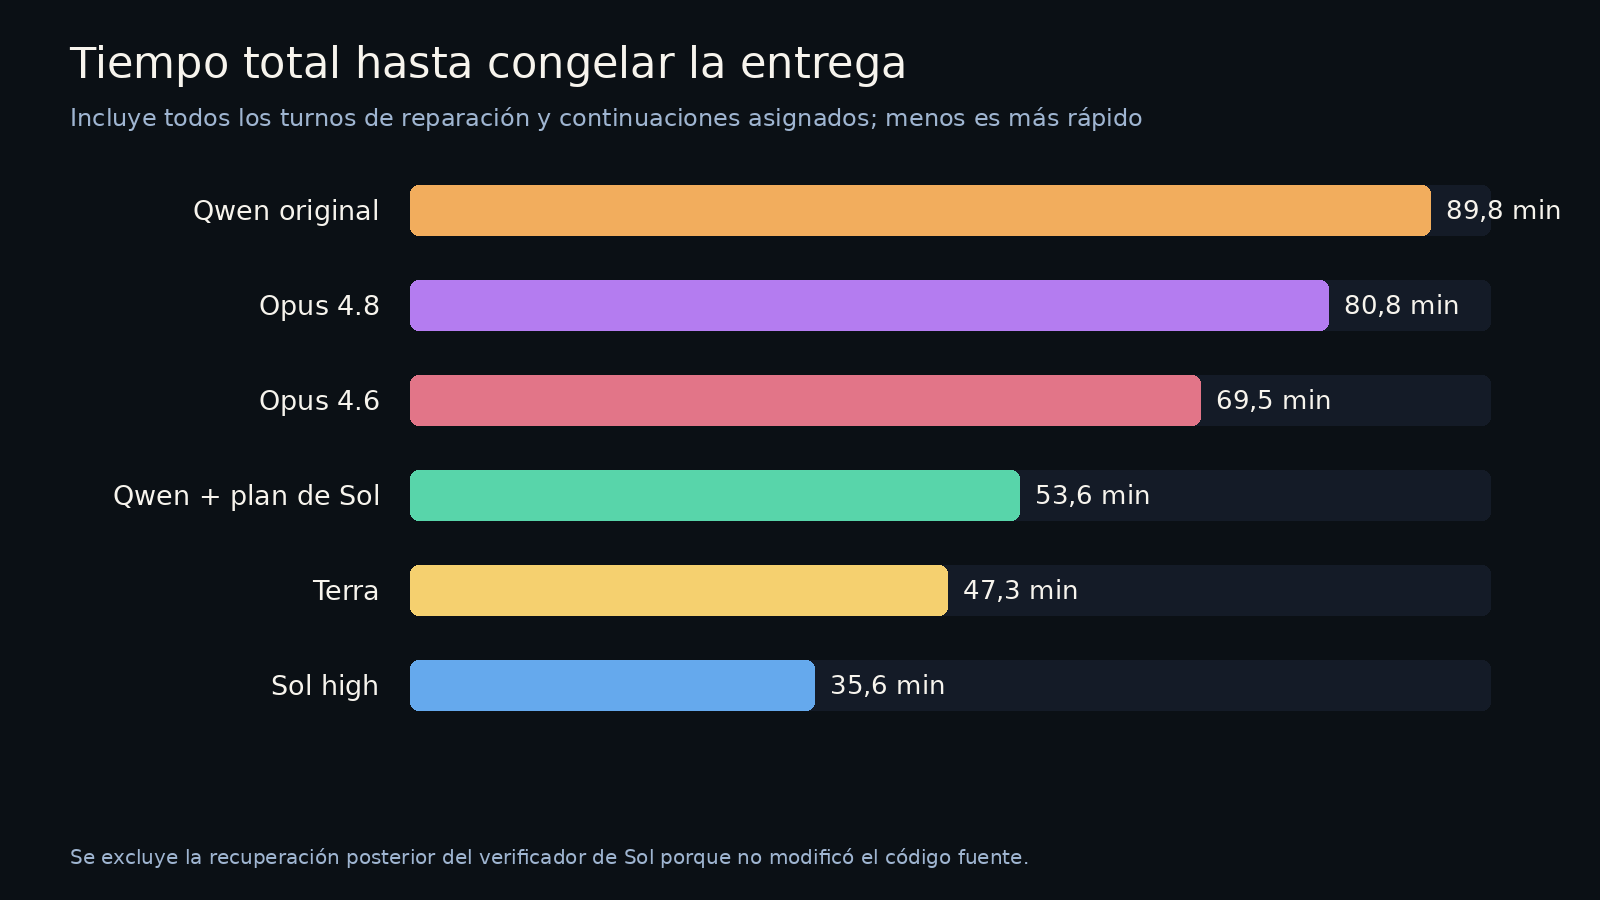
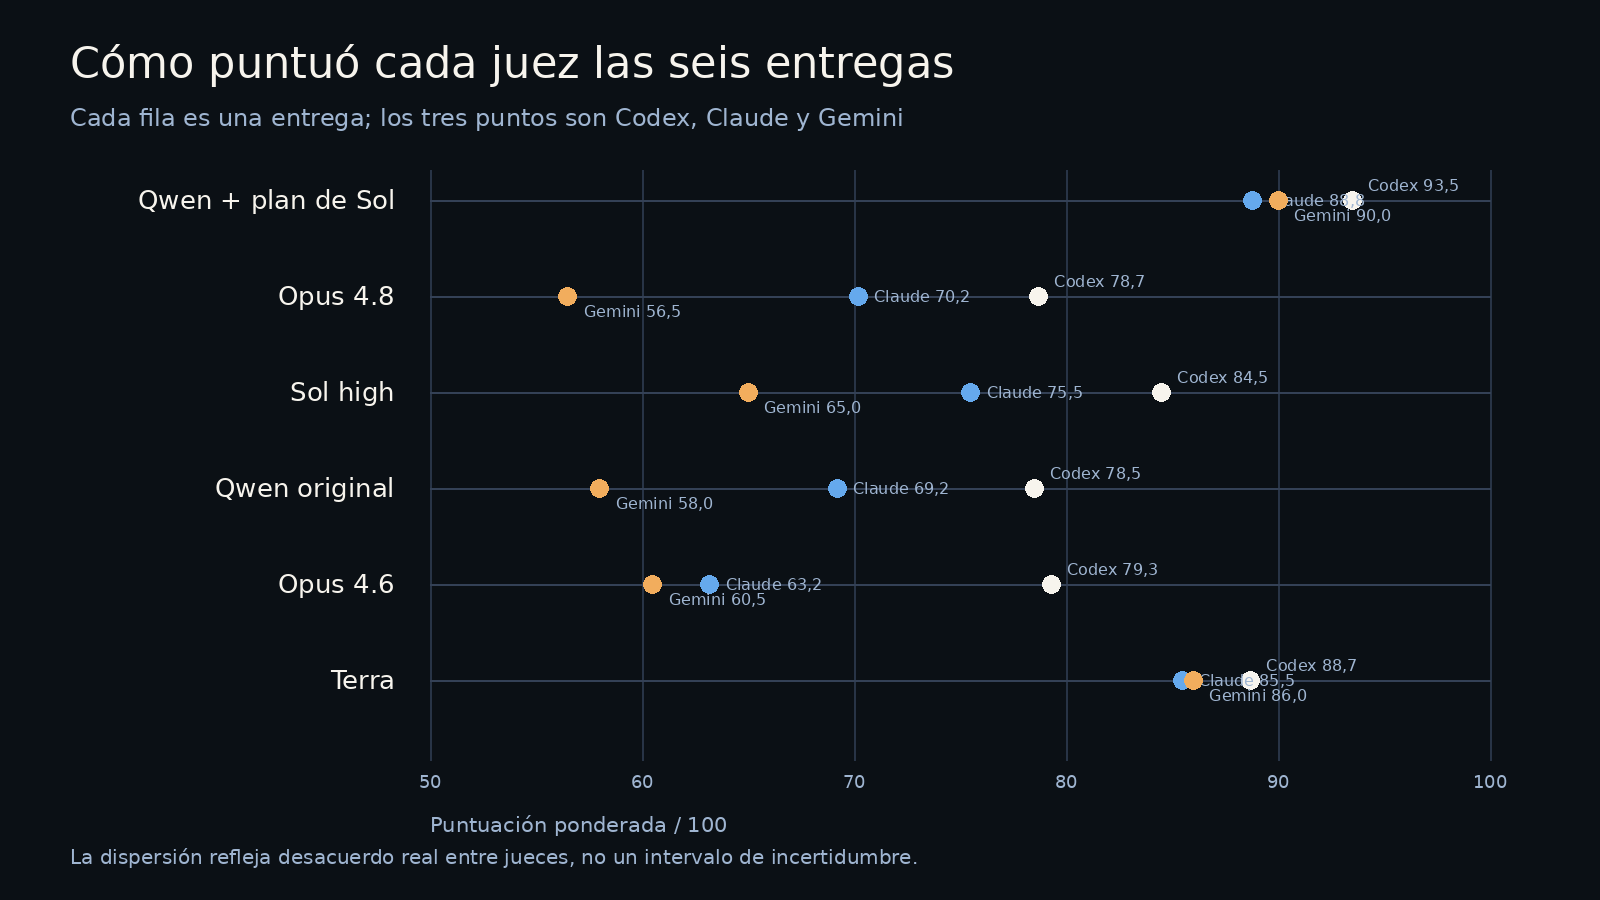
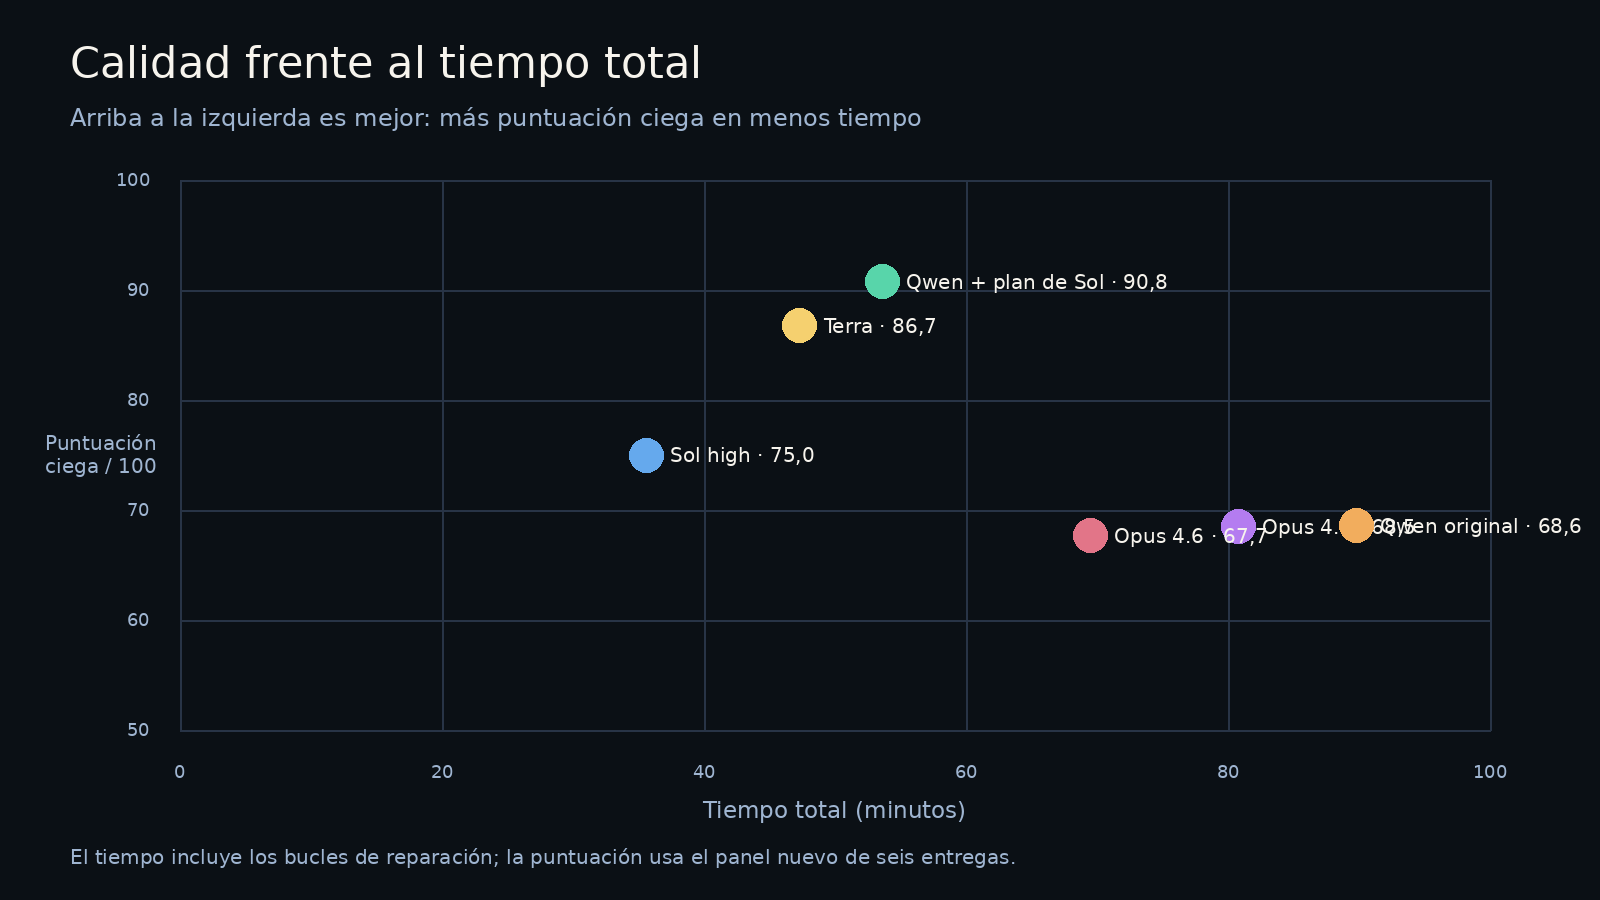
| Qwen3.8 27B local | Prompt + plan de Sol | OpenCode + Ollama | 53 min 34 s | 90,75 |
| Codex GPT-5.6 Terra | Solo prompt | Codex CLI | 47 min 18 s | 86,73 |
| Codex GPT-5.6 Sol high | Solo prompt | Codex CLI | 35 min 39 s | 74,98 |
| Qwen3.8 27B local | Solo prompt | OpenCode + Ollama | 89 min 51 s | 68,57 |
| Claude Opus 4.8 | Solo prompt | Claude Code | 80 min 47 s | 68,48 |
| Claude Opus 4.6 | Solo prompt | Claude Code | 69 min 30 s | 67,68 |
Lo que entregó realmente la ejecución ganadora
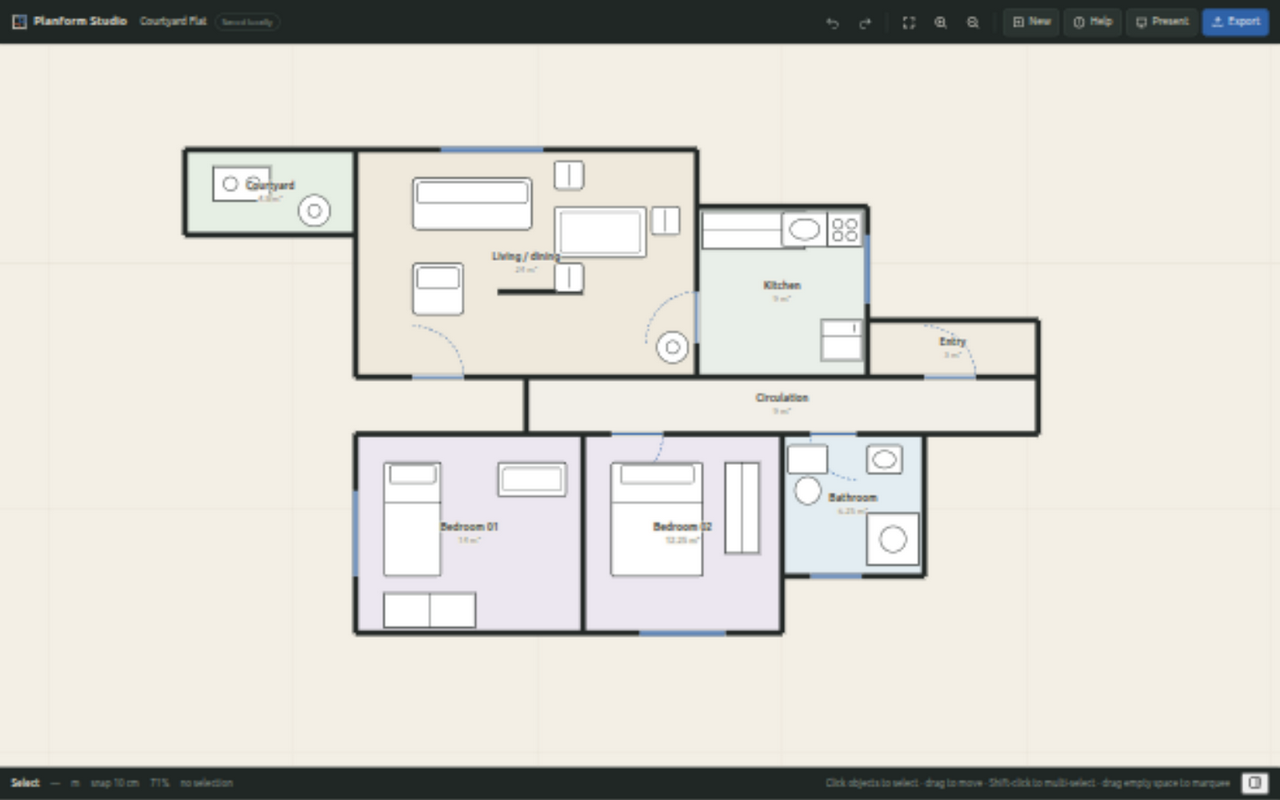
Una puntuación solo vale algo si detrás hay una aplicación que funciona, así que antes de los números, esto es lo que entregó Qwen con plan: se abría con un proyecto completo de ocho habitaciones amuebladas y con los controles necesarios para editarlo.
02 / El plan
El primer resultado de Qwen fue normalito. Después dejé de pedirle que también fuese el arquitecto.
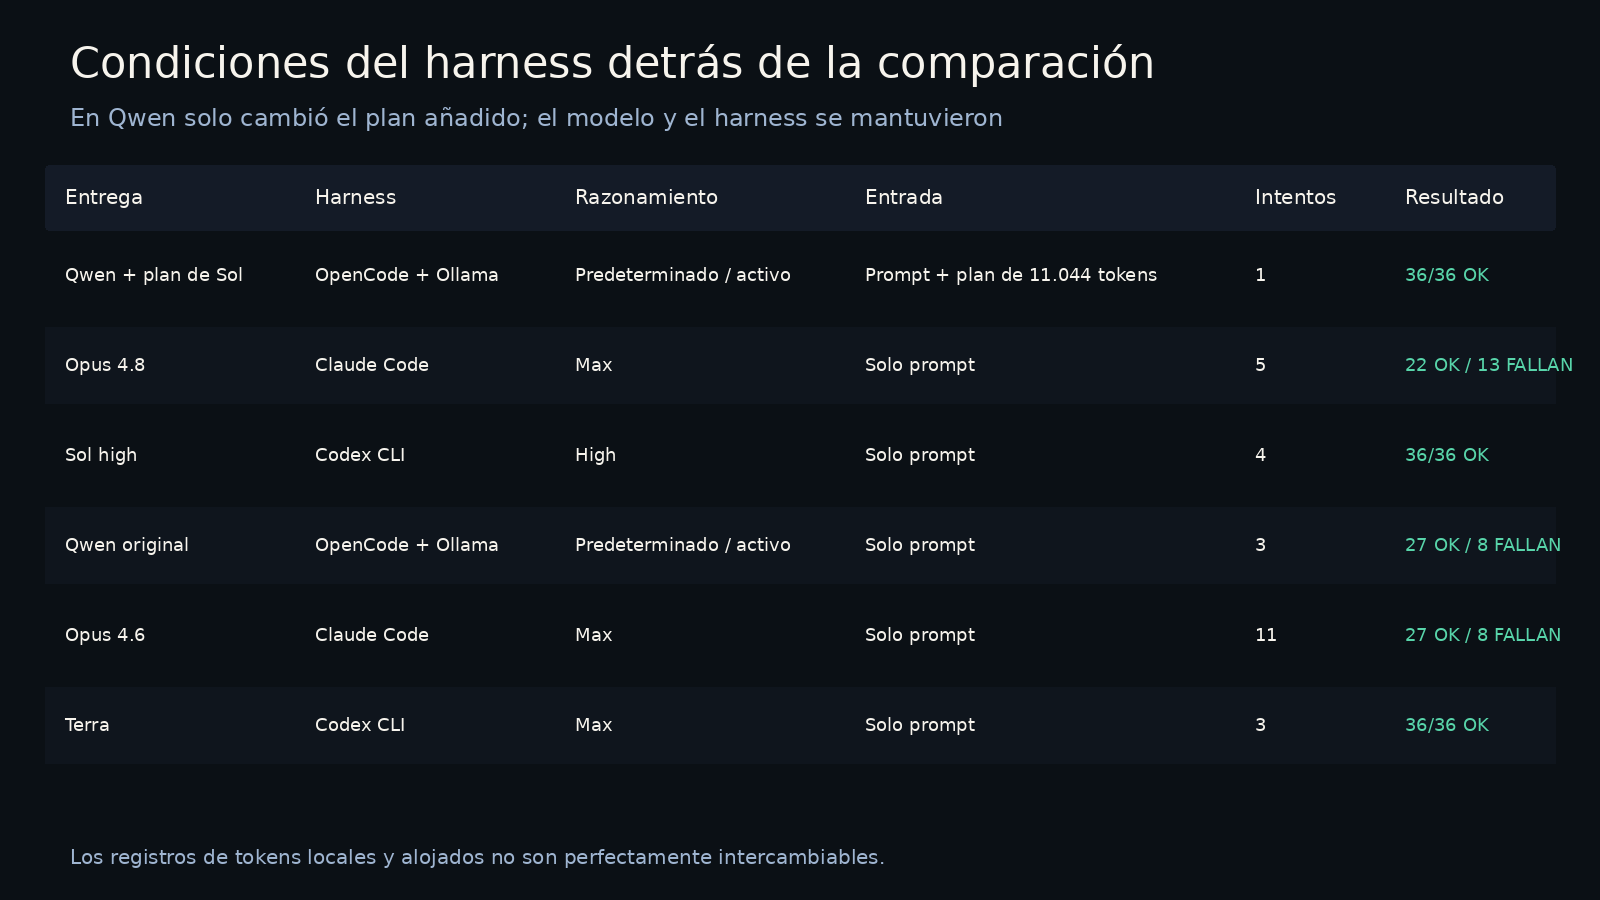
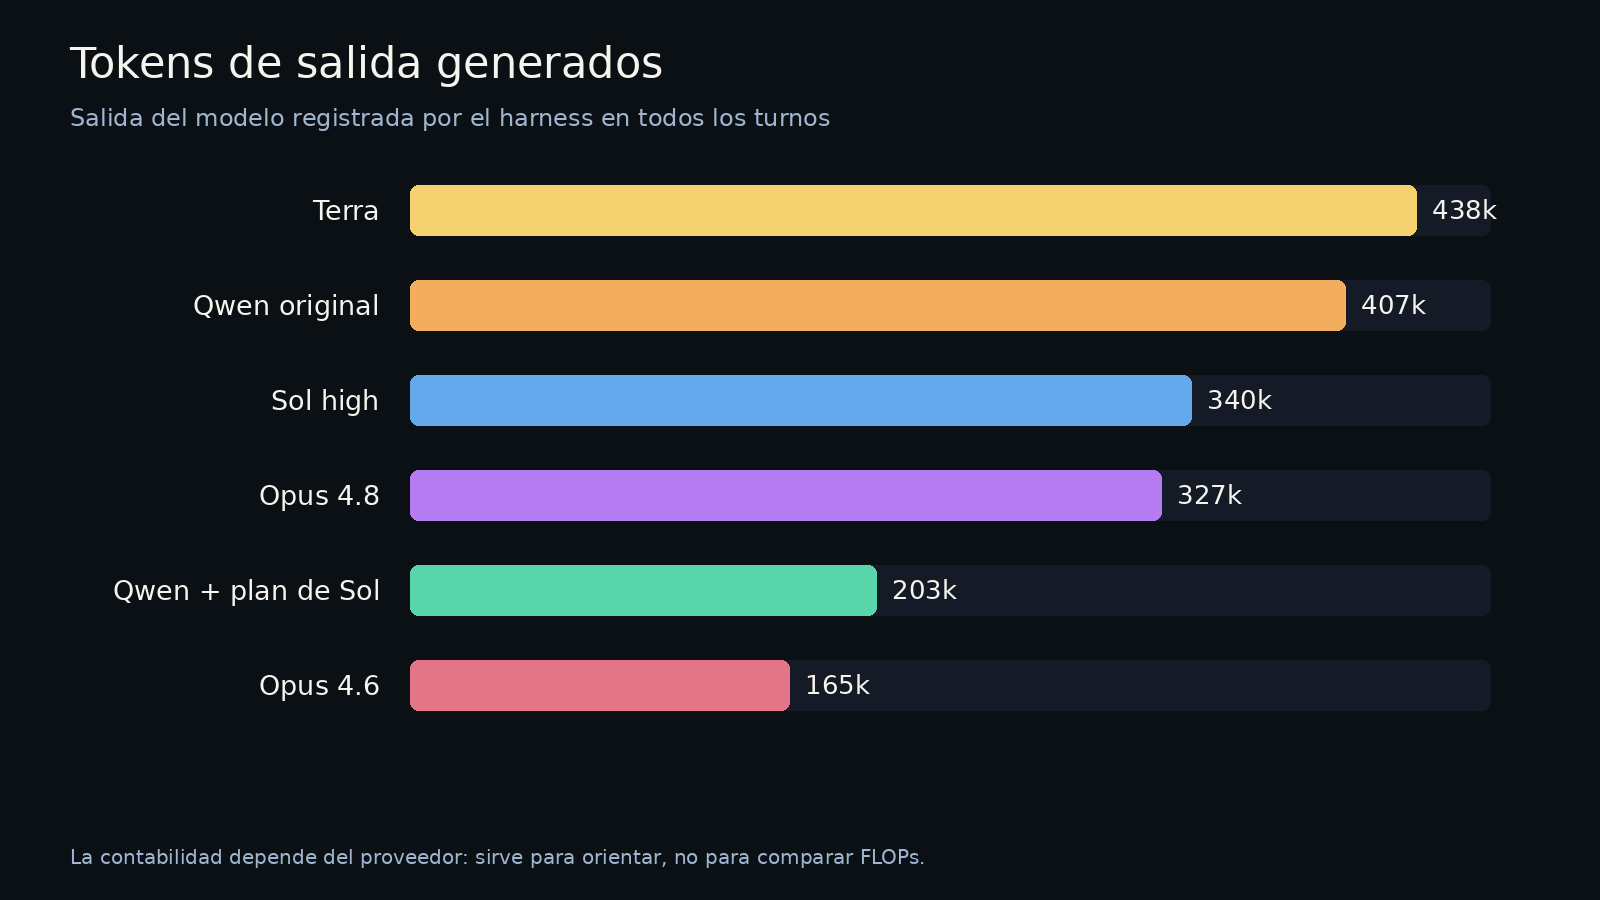
Qwen con solo el prompt agotó casi todo el límite de 90 minutos y produjo 407.074 tokens de salida a lo largo del bucle de herramientas. Sacó un 68,57/100. Quedó en la misma franja que las dos ejecuciones de Opus, pero el producto tenía los síntomas habituales de un agente resolviendo lo que tenía justo delante: código local decente, decisiones de producto inconsistentes y demasiado poco tiempo reservado para integrar y comprobar.
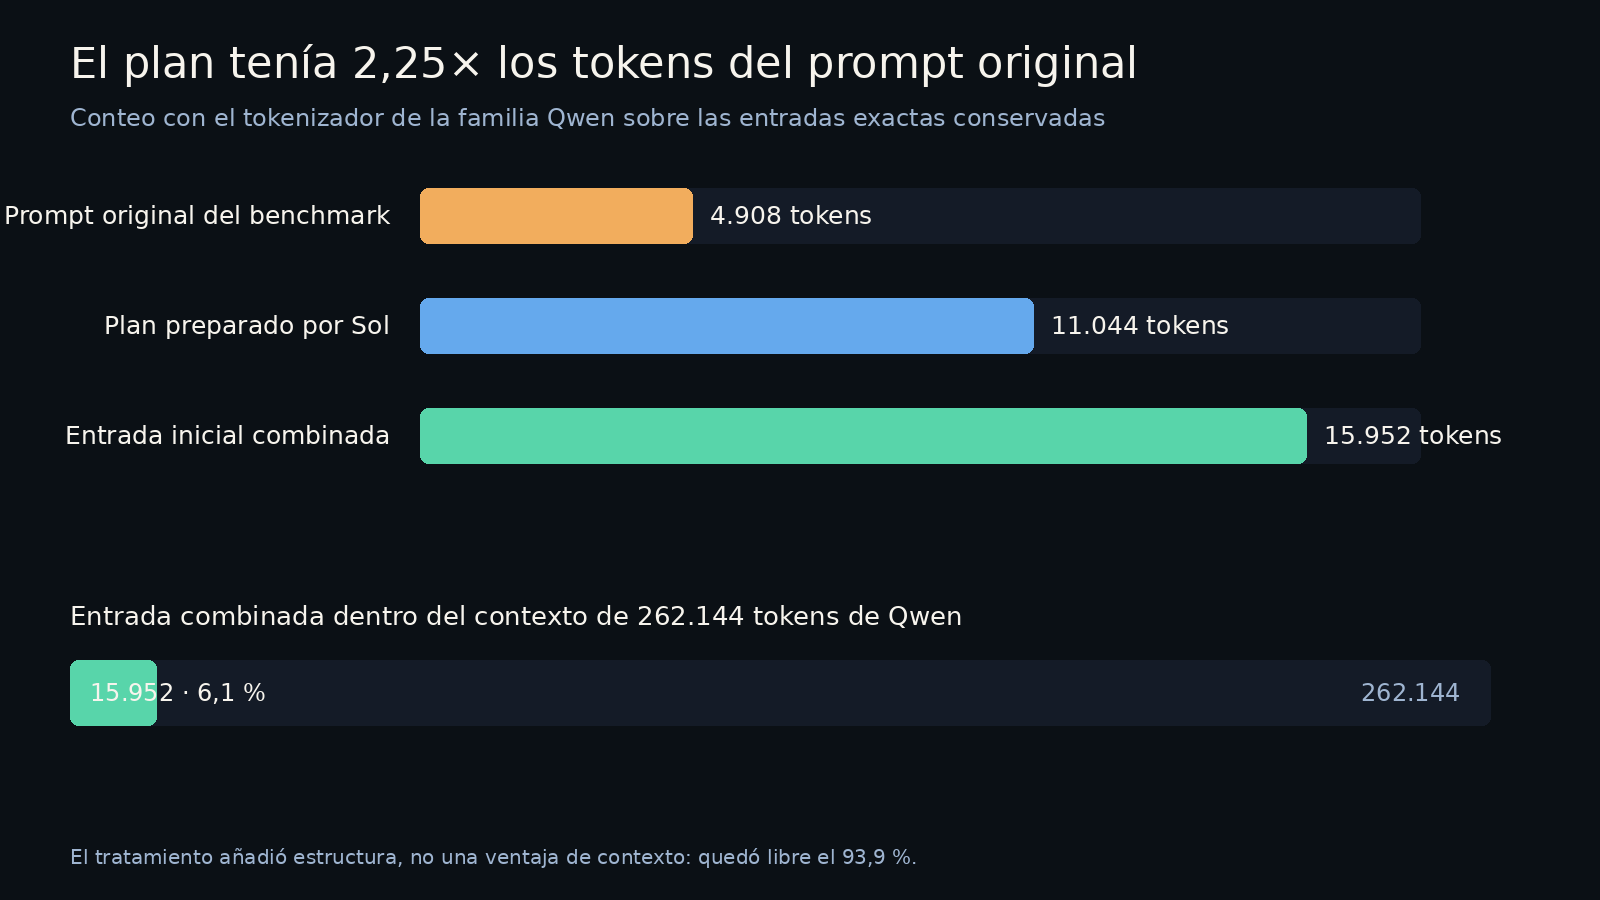
Para la ejecución planificada mantuve el modelo local, su modo de razonamiento, OpenCode, Ollama, la ventana de contexto de 262K y la regla de un único intento. Antes de que empezara Qwen, Sol high recibió el encargo del CAD y escribió un plan de ejecución. Después, Qwen recibió el prompt original de 4.908 tokens más ese plan de 11.044.
¿Y qué había en ese plan? Fijaba la arquitectura, nombraba los invariantes del estado, dividía la entrega en fases ordenadas por dependencias, especificaba el modelo de interacción, definía objetivos visuales y asociaba comprobaciones a cada función arriesgada. Sobre todo, le dejaba claro a Qwen qué significaba «terminado» cuando todavía quedaba tiempo para hacer algo al respecto.
03 / La revisión
No quería que el resultado dependiera de mi gusto
Copié los seis espacios de trabajo CAD en paquetes de revisión sellados. Quité los nombres de los modelos, la telemetría de generación, las rutas originales, los tiempos y los informes que cada agente había escrito sobre sí mismo. La clave que relacionaba cada entrega con su modelo siguió oculta hasta que hubo tres votos válidos.
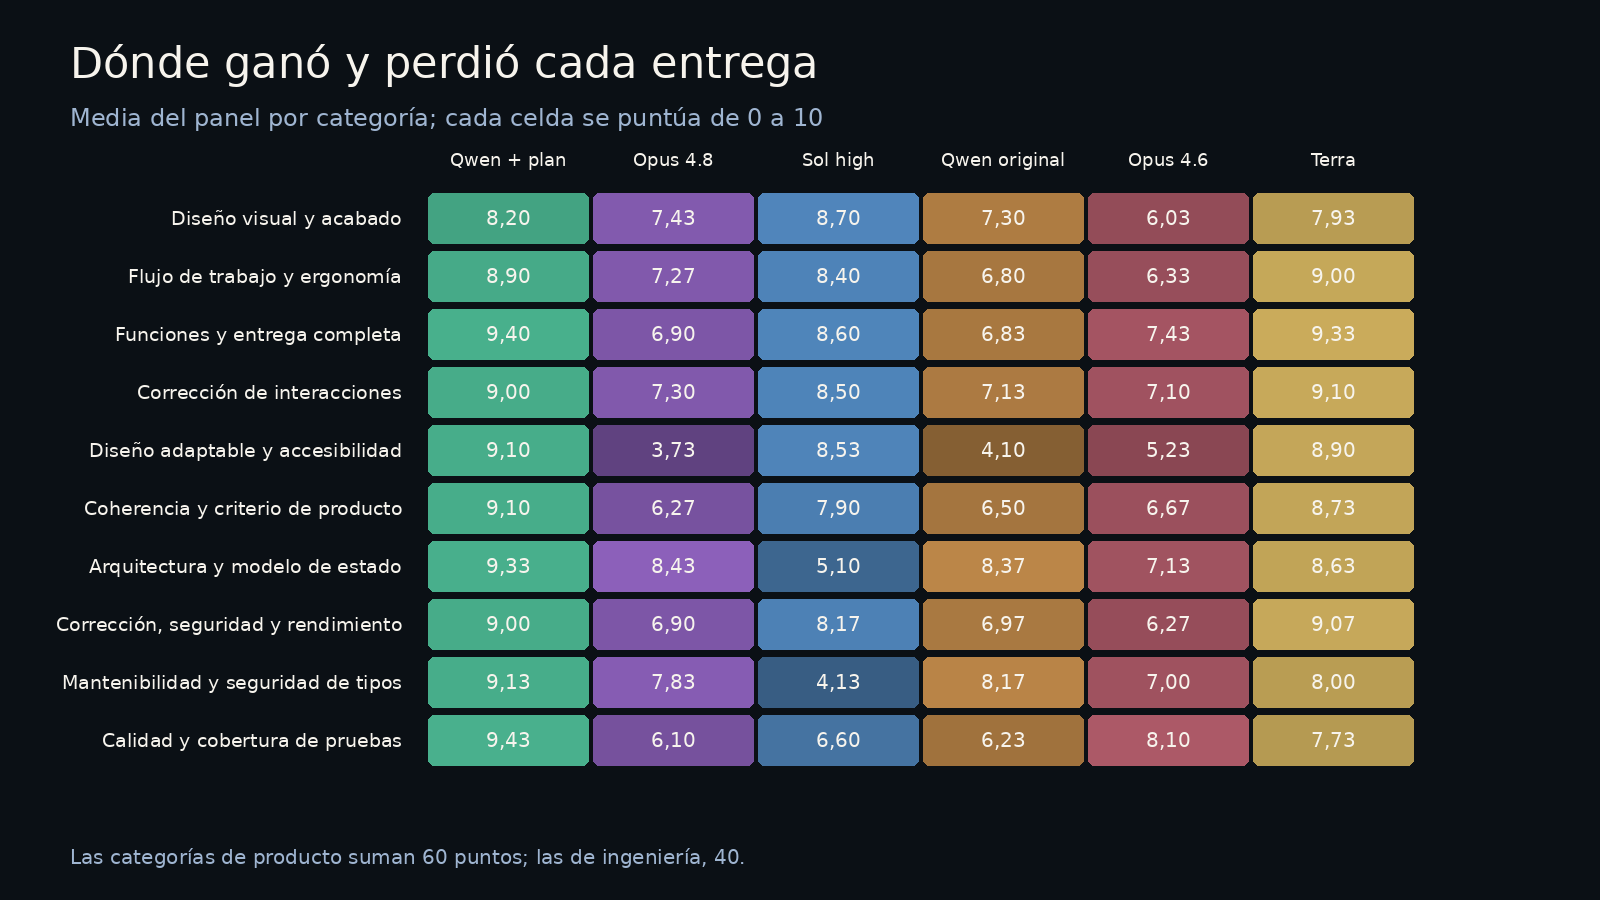
Codex Sol, Claude Opus y AGY Gemini 3.1 Pro High revisaron por separado el código y el producto en diez categorías definidas de antemano. El producto valía 60 puntos; la ingeniería, 40. Los tres eligieron por su cuenta la entrega de Qwen con plan, con notas de 93,50, 88,75 y 90,00.
04 / El dinero
El plan fue pequeño comparado con la implementación
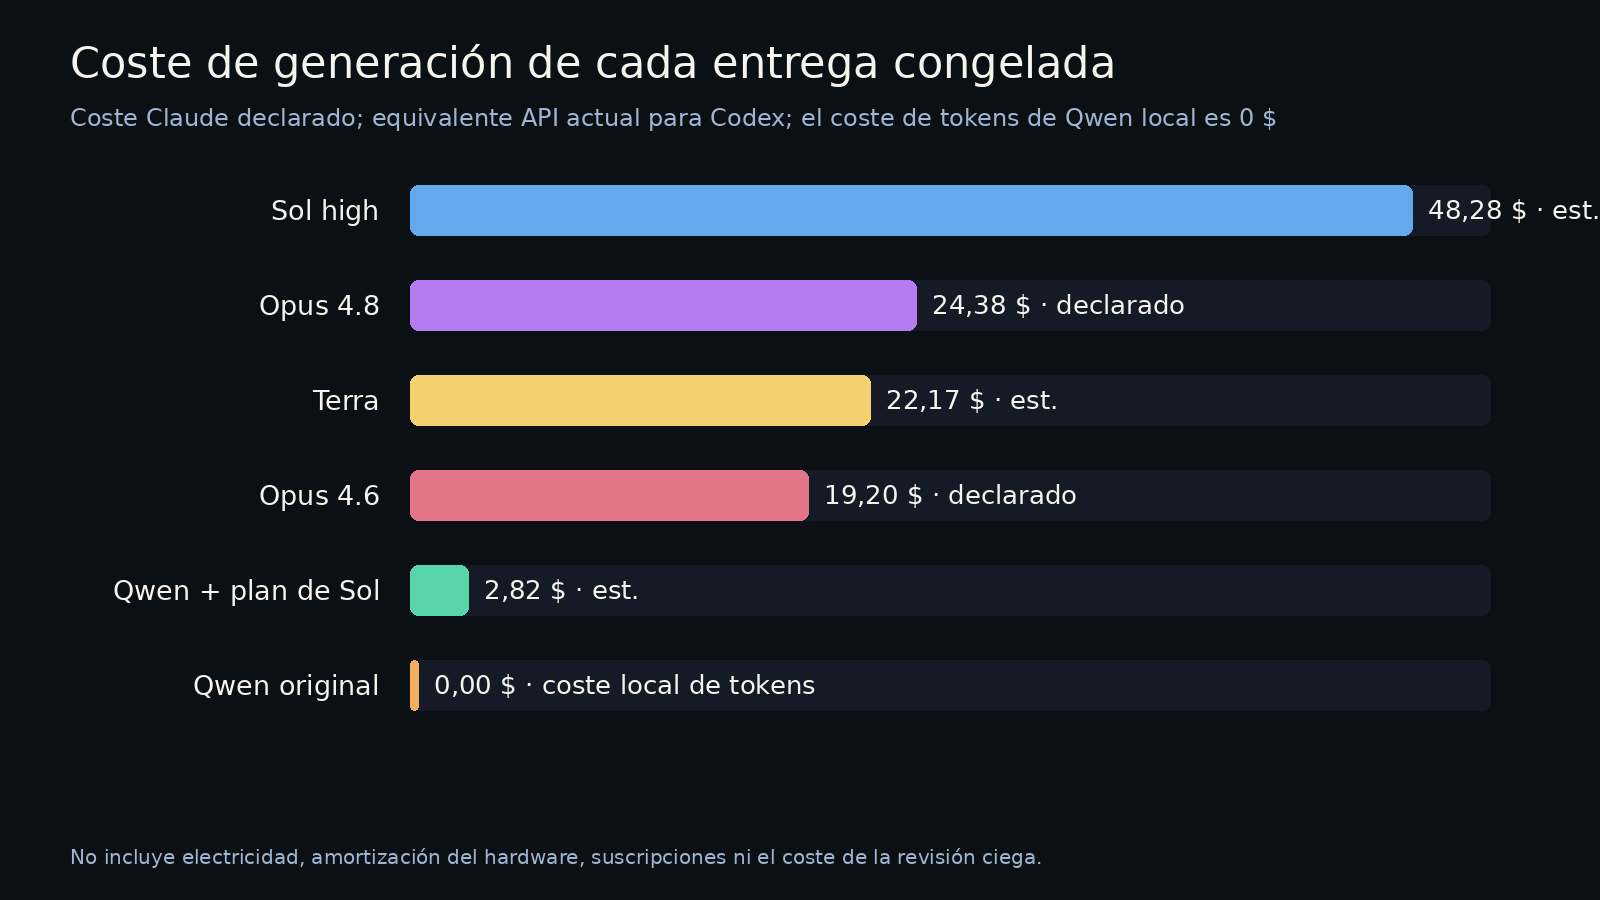
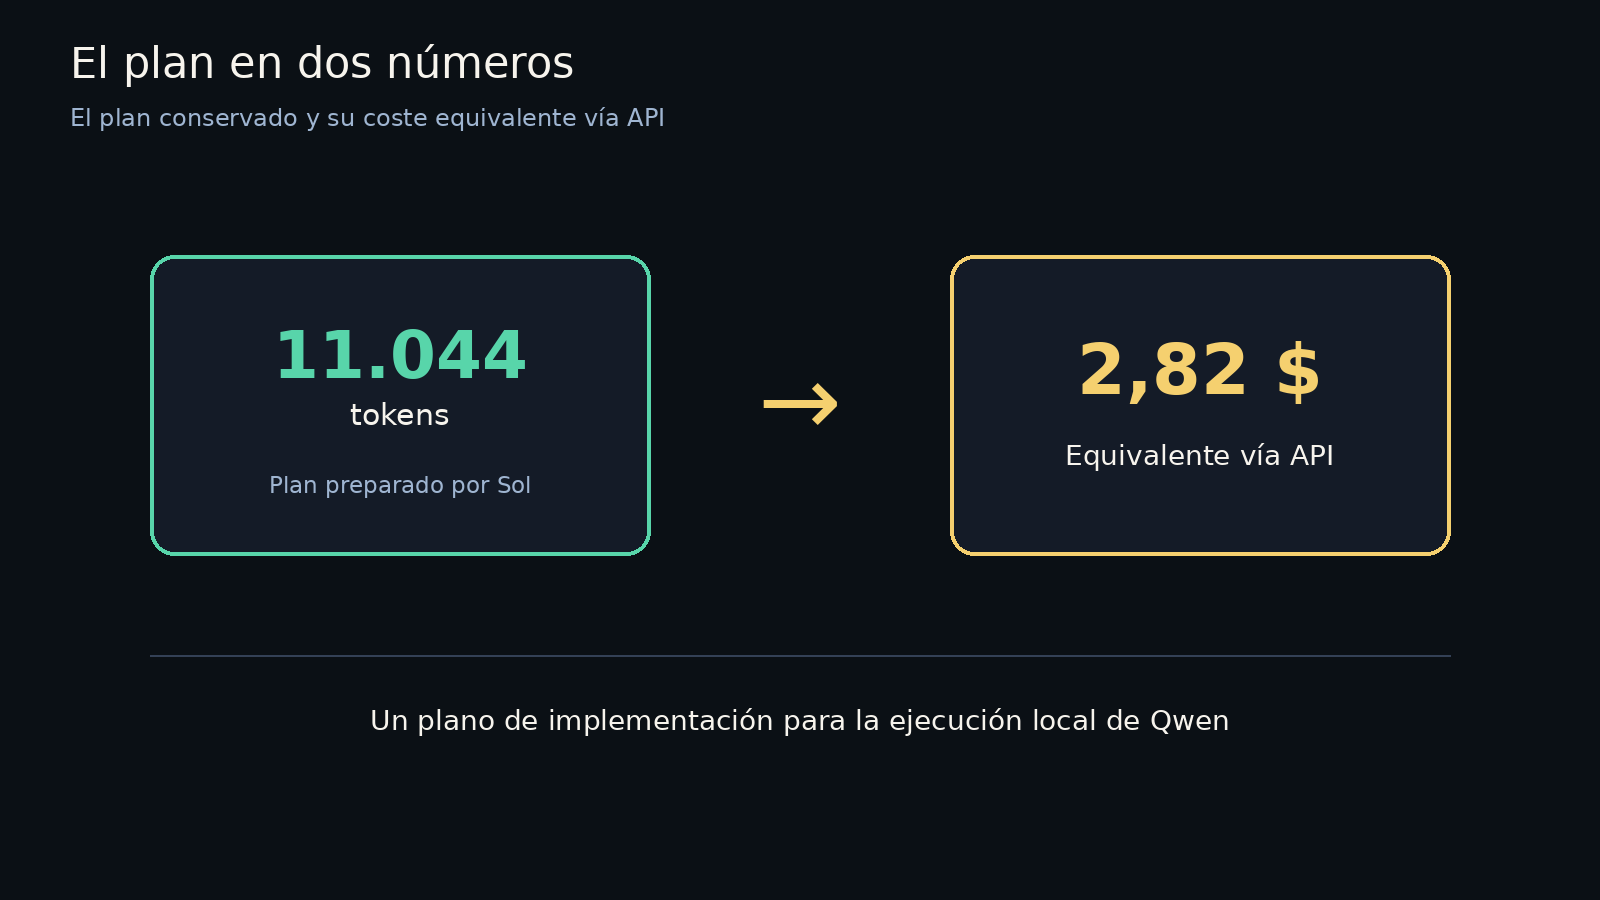
¿Y cuánto costó el plan? El documento completo de Sol tiene 11.044 tokens, que a precios de API salen por 2,82 $. Qwen en local no le paga tokens a ningún proveedor, aunque eso no convierte en gratis la electricidad ni la 5090. Compáralo con la implementación: Qwen solo con el prompt necesitó casi 90 minutos y 407.074 tokens de salida para llegar a 68,57. Con el plan terminó 36 minutos antes y generó más o menos la mitad.
05 / Lo que creo que pasó
Tener contexto no es lo mismo que saber utilizarlo
Qwen no se convirtió de repente en un modelo mejor. El plan eliminó las partes del trabajo en las que había sido más débil: decidir la arquitectura del producto mientras escribía código, mantener prioridades durante un bucle largo de herramientas y reconocer cuándo un avance local estaba creando un riesgo global.
Piensa en la diferencia entre un arquitecto y un buen constructor. Qwen solo con el prompt tenía que ser las dos cosas a la vez, en plena obra y con el reloj corriendo. Con el plan, Sol ya había dibujado el edificio y Qwen pudo dedicarse a lo que hacía bien: construir un diseño amplio y explícito dentro de una ventana de 262K, comprobar lo que había hecho y entregar una aplicación coherente. El plan ocupó una parte pequeña de esa ventana; la mejora vino de cómo estaba estructurada la información, y el contexto nunca estuvo cerca de llenarse.
Eso mismo explica por qué Sol sin plan no ganó: el mejor arquitecto de la prueba también tuvo que construir mientras dibujaba. Entregó la aplicación con mejor acabado visual y se quedó en 74,98 porque la estructura de ingeniería y la mantenibilidad eran mucho más débiles.
La conclusión
Si ya tienes un modelo local capaz, gasta el siguiente dólar en el plan
Los agentes frontier siguen teniendo una ventaja importante: sus harnesses toman buenas decisiones alrededor del modelo. Este experimento sugiere que parte de esa ventaja se puede escribir y entregar. El modelo local de 27B no recibió ningún fine-tuning ni una ventana de contexto mayor; solo una descripción mucho mejor del trabajo.
El resultado que me importa es el controlado: 68,57 pasó a 90,75 con el mismo modelo, la misma máquina, el mismo harness y la misma tarea, y un plan de 11K tokens convirtió un intento errático de 90 minutos en el ganador unánime. Si tienes un modelo capaz en local, esto lo puedes probar mañana, que es bastante más de lo que da de sí otra discusión sobre qué modelo encabeza el leaderboard esta semana.
Ver el trabajo